한 줄 요약: 규칙 기반의 계산과 데이터 검증은 이미 AI가 인간을 넘어섰으니, 마케터는 단순 작업자를 벗어나 ‘비즈니스 맥락 정의’와 ‘전략적 의사결정’에 집중해야 한다.
1. 실험 배경: “AI 벤치마크는 현실 업무를 반영하고 있는가?”
인재 플랫폼 기업 Mercor가 발표한 리서치 페이퍼(2026년 10월 발행) “Human Baselines for Benchmarks: AI Now Outperforms Junior Accountants“는 매우 흥미로운 질문에서 출발합니다.
“AI 벤치마크 점수는 치솟고 있는데, 왜 실제 경제 통계상 생산성 지표는 체감되지 않는가?”
연구진은 이 간극을 검증하기 위해 평균 5.4년 경력의 현직 미국 공인회계사(CPA) 12명을 섭외해, 실제 재무/회계 실무를 모사한 APEX-Accounting 과제를 부여했습니다.
과제 성격: 비영리단체 프로그램별 예산 배분, 호텔 매출 오류(주차 수익이 객실 매출로 잘못 분개된 건 등) 수정 및 조정 분개, 이벤트 장소 수익 차이 분석, 리스 부채/사용권 자산 롤포워드 등 현실적인 월말 결산 시나리오.
방식: 가상 머신(VM) 환경에서 수십 개의 엑셀 및 참고 문서를 직접 분석하고 계산. (인간 단독 vs Claude 단독 vs 인간+Claude 협업 비교).
2. 충격적인 결과: 단독 AI의 완승
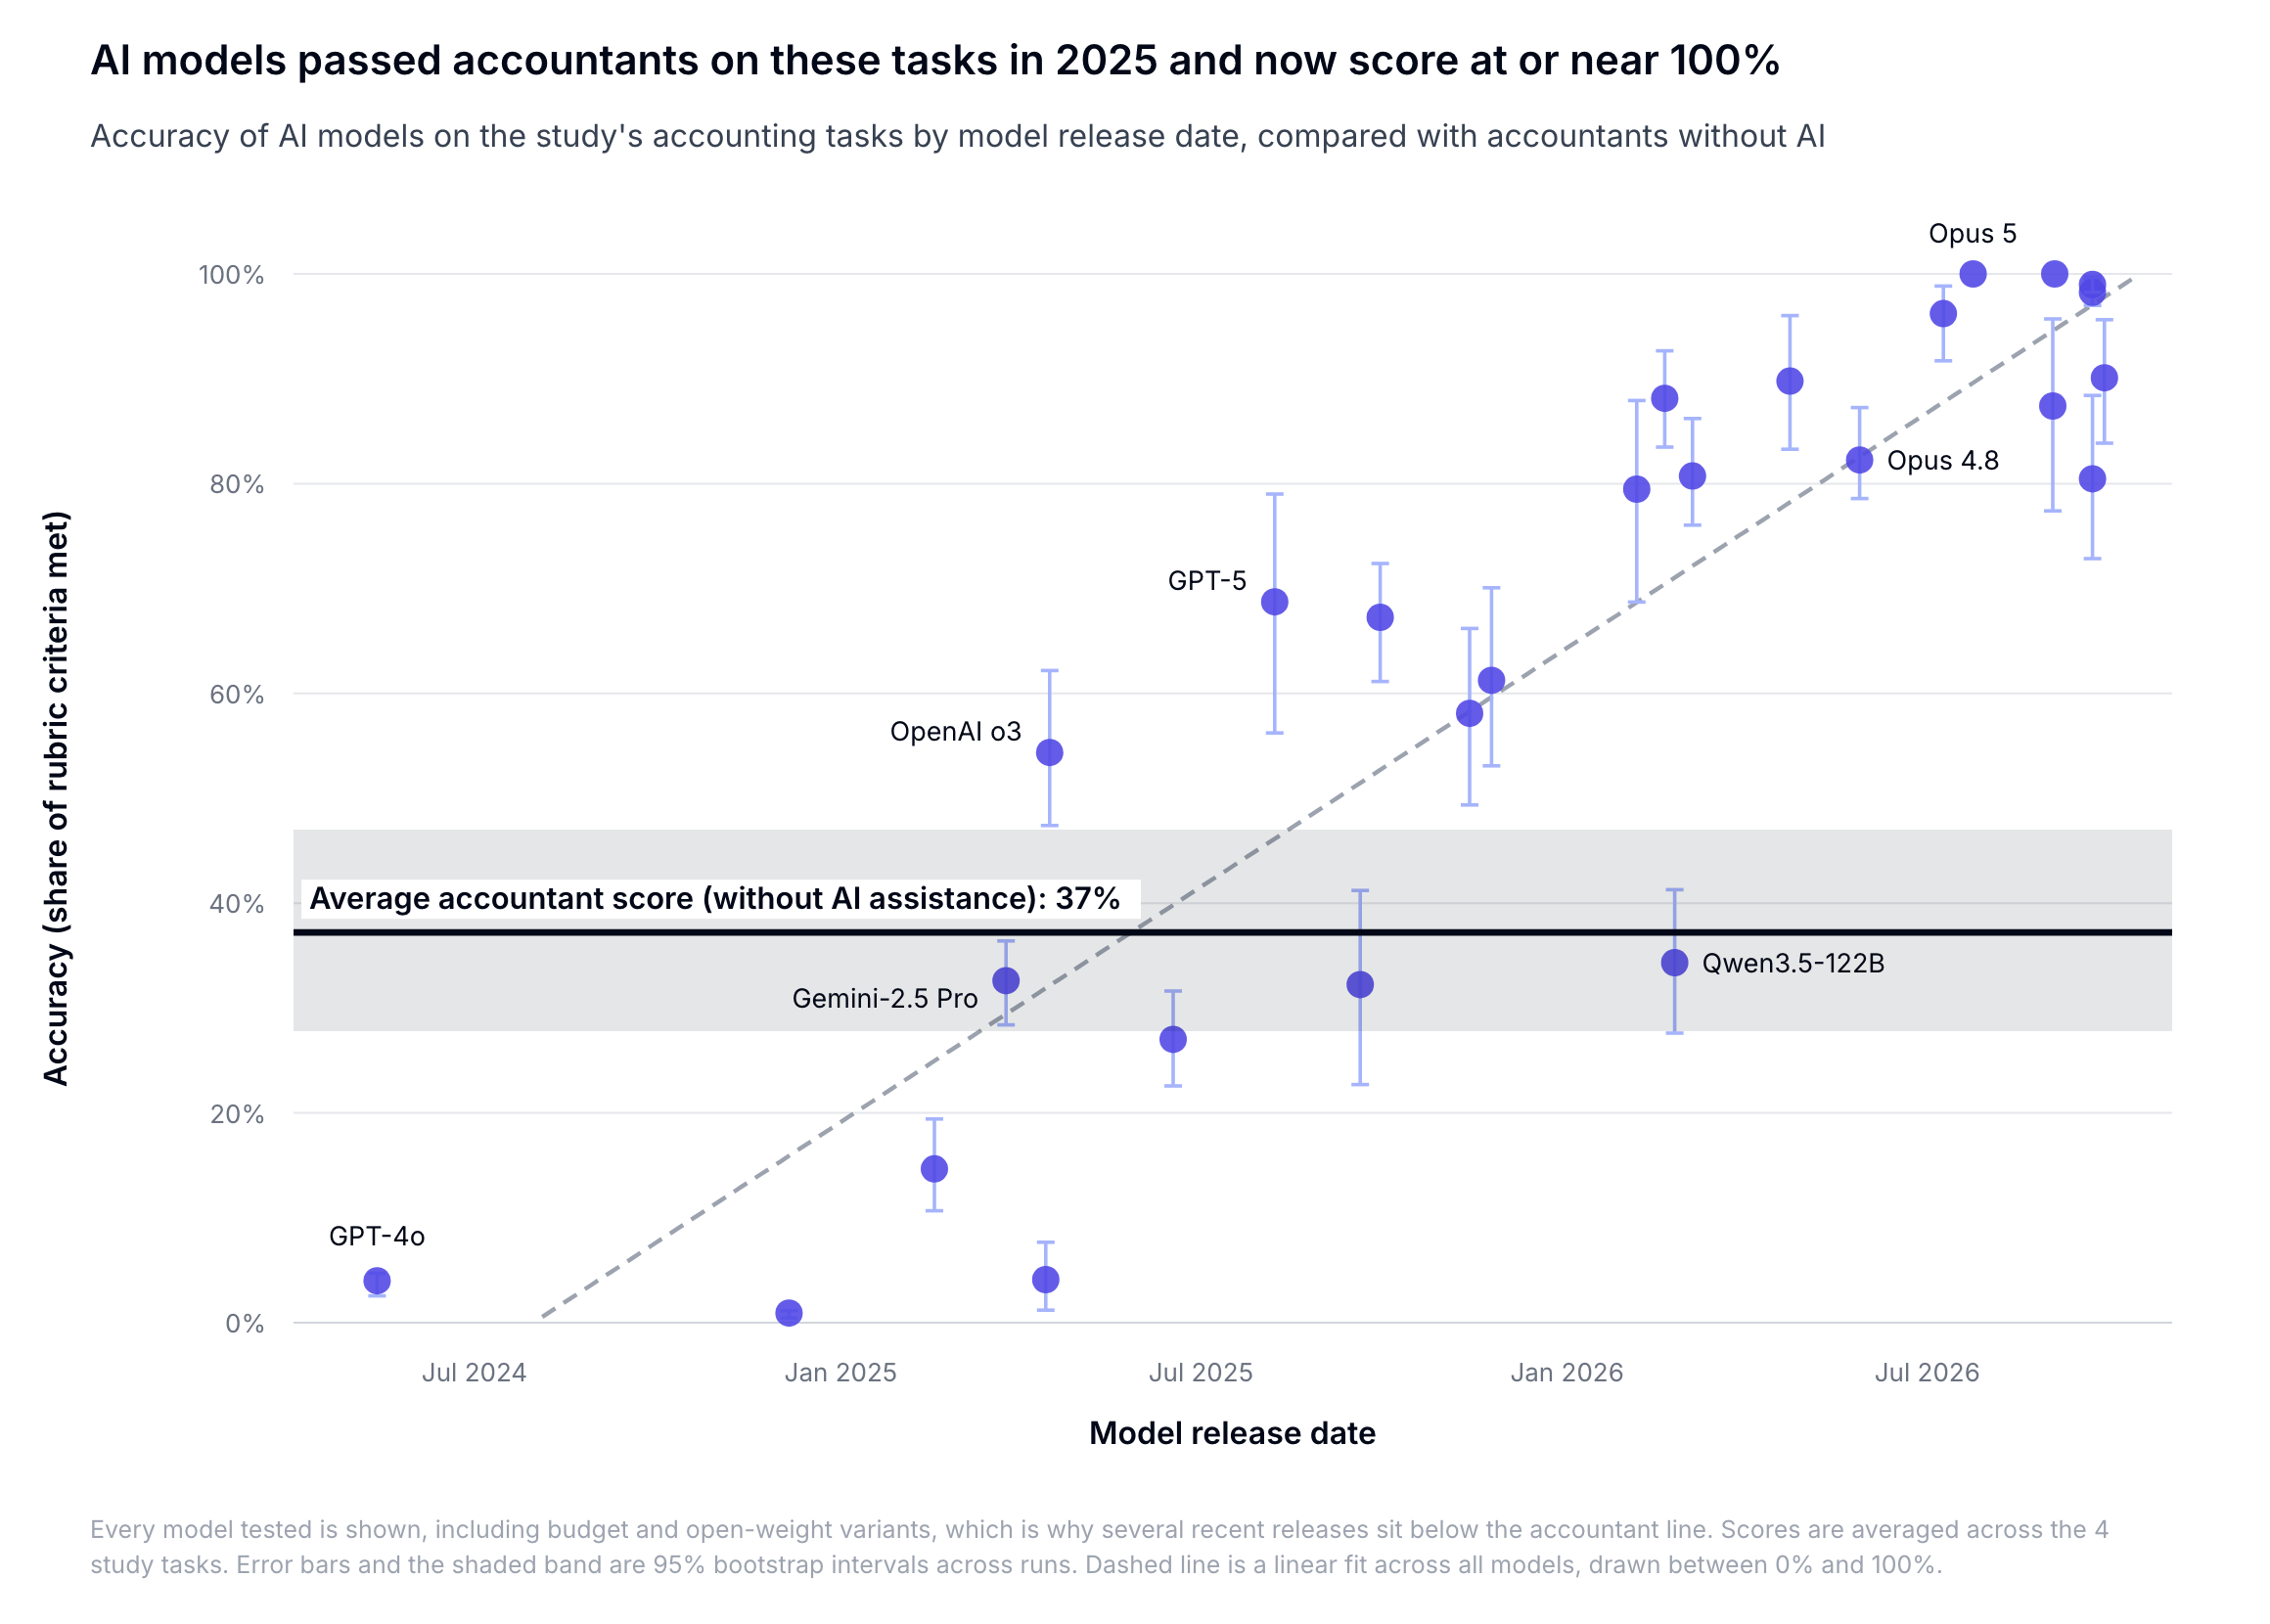
속도와 정확도의 격차: 최신 프론티어 모델(Claude Opus 5)은 4개 과제 전반에서 루브릭(채점 기준) 평가 100%에 달하는 정답률을 기록했습니다. 반면, AI 없이 작업한 주니어 회계사의 평균 점수는 37%에 머물렀습니다.
AI와 함께 작업한 속도와 정확도의 격차 속도 비교: 모델은 복잡한 데이터 시트 수십 개를 교차 검증하고 계산하는 작업을 몇 분 안에 끝냈으며, 인간 작업자에 비해 약 34배 빠른 처리 속도를 보였습니다.
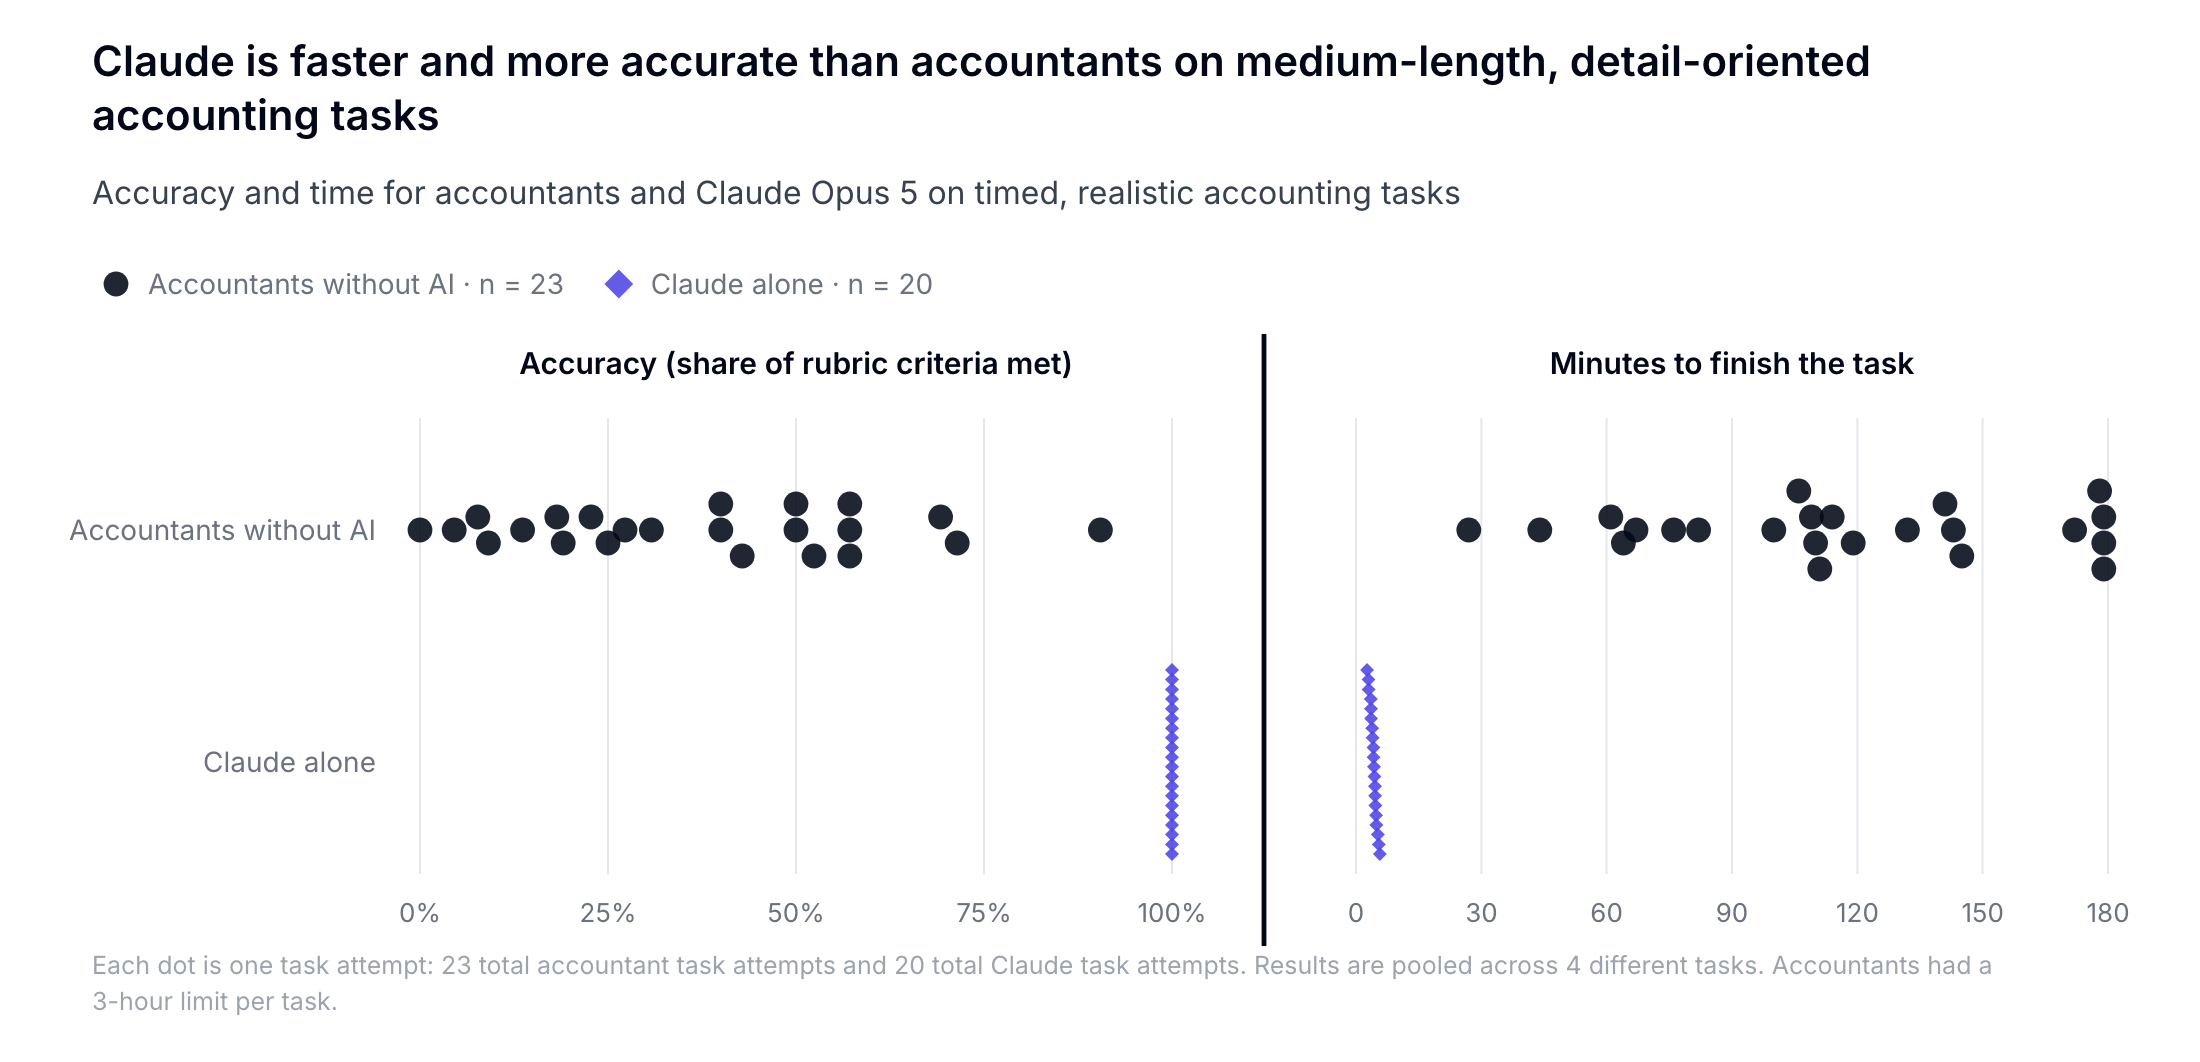
AI와 인간 회계사의 작업 속도 비교 인간 + AI 협업의 모순: 회계사가 Claude를 보조 도구로 활용했을 때, Claude 단독 작업보다 시간은 15배 더 걸렸고 정확도는 오히려 소폭 하락했습니다. 인간이 올바른 AI의 제안을 의심해 잘못 수정하거나, 인간의 개입으로 불필요한 지연이 발생했기 때문입니다.
인간과 AI 의 협업에 대한 이중성 비용 차이: 채점 기준 항목당 비용으로 환산했을 때, AI는 $0.21 수준인 반면 회계사는 약 $10.35로 거의 50배(49x) 가까운 비용 차이를 나타냈습니다.
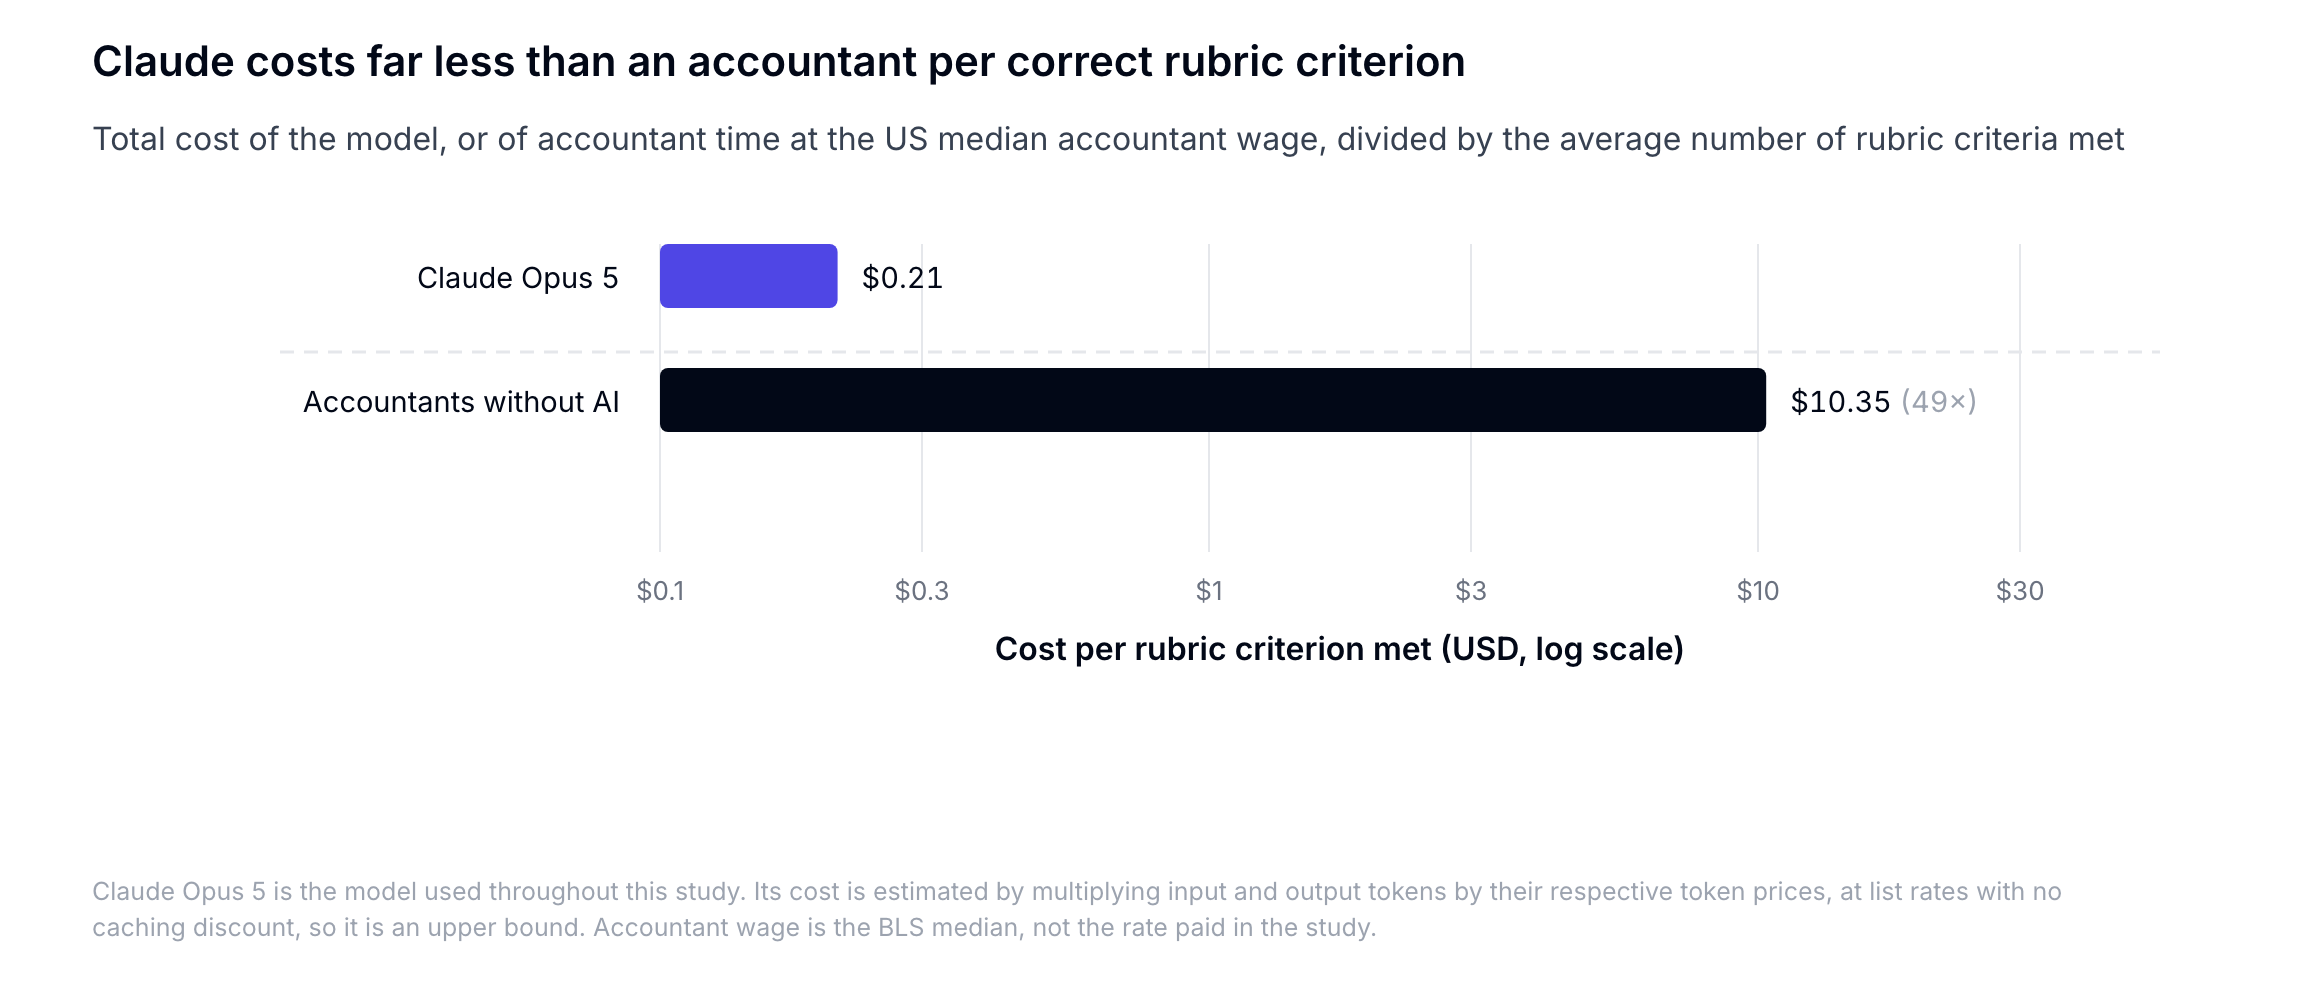
인간과 AI의 비용 환산
3. 심층 분석: 회계사의 특성과 추론 모델(Reasoning Model)의 성장
왜 회계 도메인에서 이런 압도적인 결과가 나왔을까요? 이는 회계라는 직무의 특성과 최근 LLM의 구조적 진화가 맞물린 결과입니다.
① 법률·회계 기준(규칙)에 대한 ‘압도적 메모리’와 ‘무제한 컨텍스트’
회계 업무는 US-GAAP이나 IFRS 같은 법률적·회계적 기준 체계(Rule-based Framework)를 엄격히 따라야 합니다. 인간은 수많은 조항과 세부 단서 조항을 기억하는 데 인지적 한계가 있고, 방대한 파일 속에서 사소한 예외 조건(예: 12월 말 숙박이 1월 3일에 청구되어 누락된 건 등)을 놓치는 피로도(Fatigue) 문제가 발생합니다. 반면 프론티어 AI는:
방대한 법률/규정 텍스트를 맥락 손실 없이 즉각 호출하고,
수백 페이지의 원장과 영수증 파일을 빠짐없이 대조(Cross-referencing)하는 데 특화되어 있습니다.
② 단순 암기를 넘어선 ‘다단계 추론 모델(Multi-step Reasoning Agent)‘의 도약
이번 실험에서 모델은 단순 질의응답이 아니라, ReAct(Reasoning + Acting) 에이전트 구조로 툴(Tool)을 호출하며 최대 250스텝에 걸쳐 문제를 해결했습니다.
- 가설 수립 및 검증: 불일치하는 계정 잔액을 발견하고 원인을 추적.
- 오류 연쇄 해결: 한 숫자의 수정이 다른 분개장에 미치는 연쇄 영향을 논리적으로 계산.
불과 1
2년 전 모델(GPT-4o 초기, Gemini 초기 등)이 2030%대 점수에 머물렀던 것과 달리, 최신 추론형 모델(Claude Opus 계열, OpenAI o-시리즈 등)이 100%에 도달했다는 점은 ‘맥락을 이해하고 다단계 논리를 검증하는 능력’이 비약적으로 성장했음을 증명합니다.
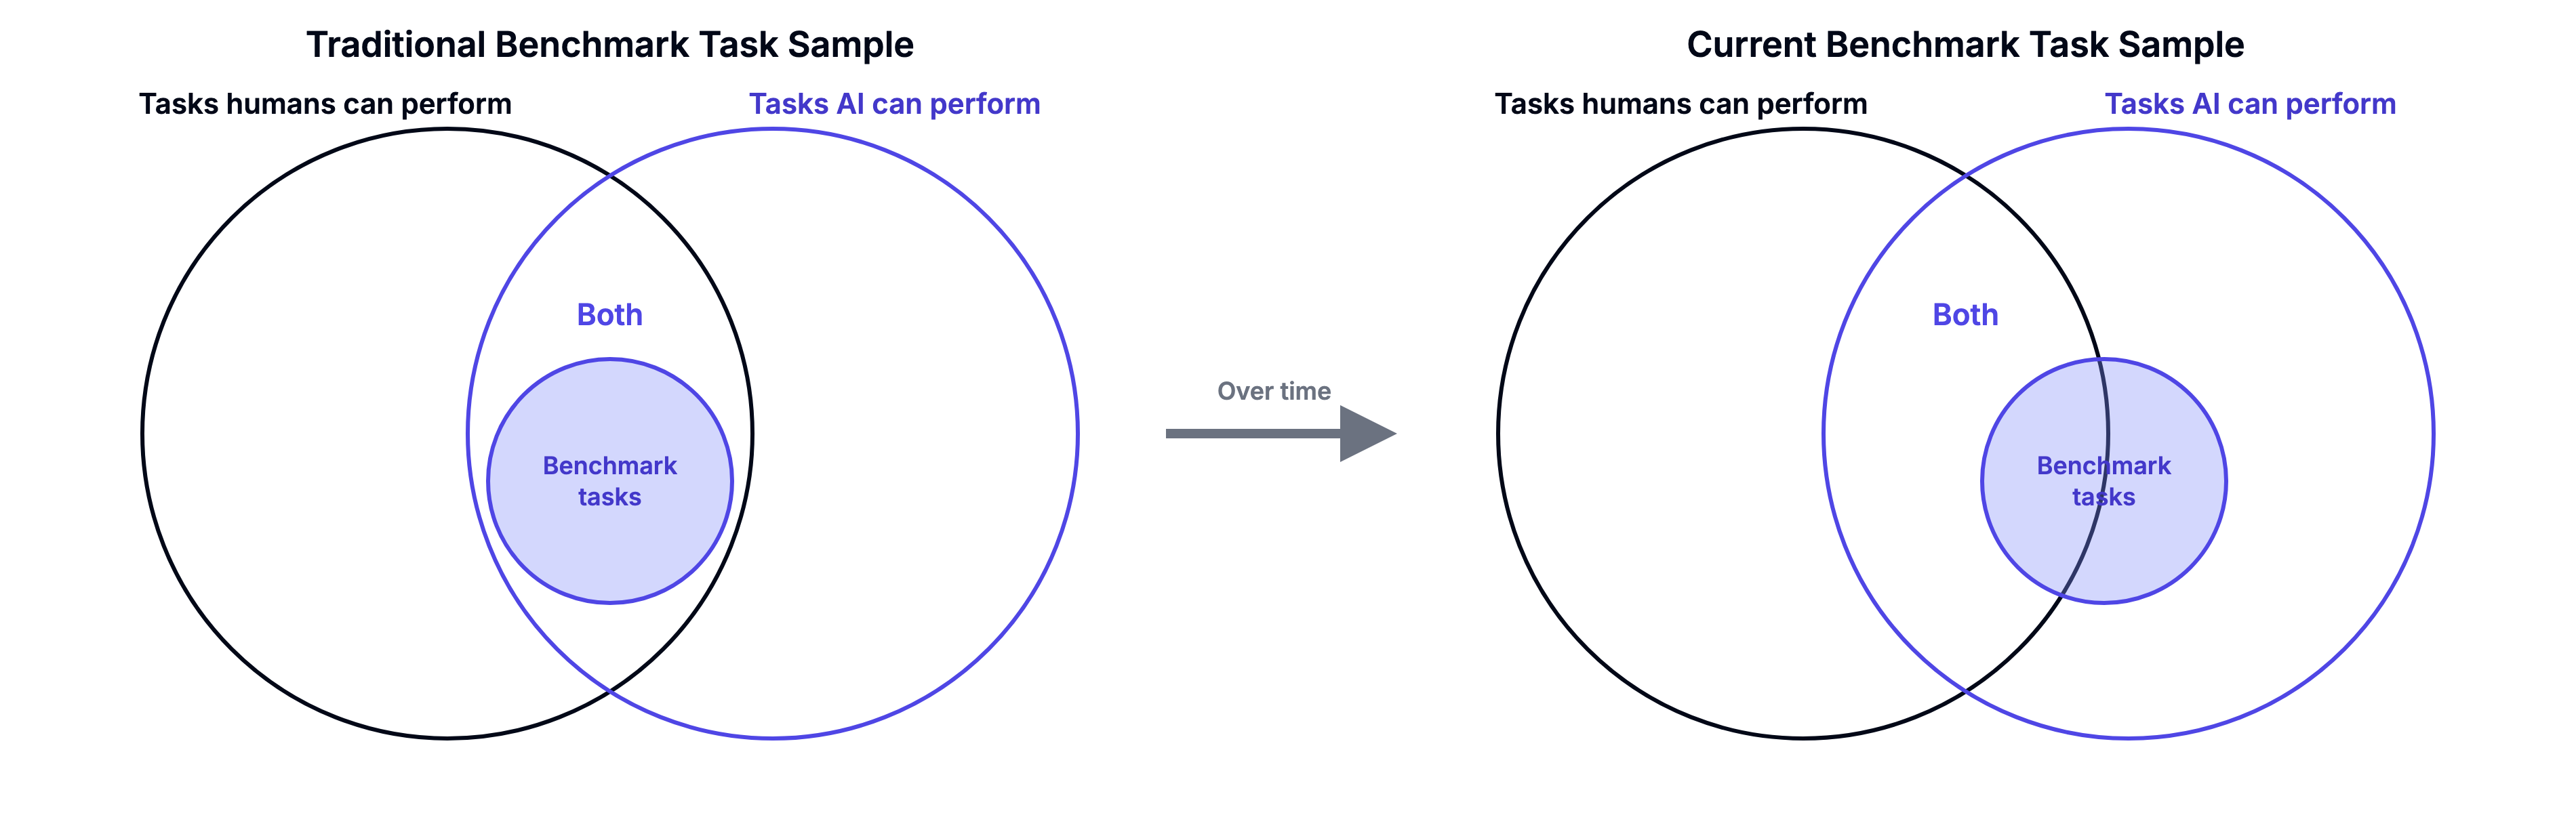
단, 회계사가 완전히 대체된다는 뜻은 아닙니다. 논문 저자들도 지적했듯, 이번 과제는 “명확한 규칙과 정답이 파일 내에 존재하는 환경"이었습니다. 실무에서는 클라이언트와의 미팅, 애매한 상황에서의 경영진 인터뷰, 조직 내부의 암묵지(Tacit Context) 수집, 그리고 결과에 대한 최종 법적 책임이 회계사의 본질입니다.
4. 디지털 마케터(Digital Marketer)에게 주는 시사점
회계사들의 이번 결과는 검색 엔진 최적화(SEO), 퍼포먼스 마케팅, 그로스 해킹을 다루는 디지털 마케터에게도 직격타가 되는 메시지를 던집니다.
과거 마케터의 주요 업무였던 ‘키워드 데이터 취합’, ‘GA4 로그 및 전환(Conversion) 데이터 대조’, ‘경쟁사 백링크 크롤링 및 태그 검수’, ‘정형화된 성과 리포트 작성’ 등은 AI가 인간보다 수십 배 빠르고 정확하게 수행할 수 있는 영역이 되었습니다.
그렇다면 마케터는 앞으로 어떤 자세와 감각을 강화해야 할까요?
1) ‘단순 오퍼레이터’에서 ‘전략적 아키텍트(Strategic Architect)‘로의 전환
지침 준수(Instruction Following)는 이제 차별점이 아닙니다: 스프레드시트를 정리하고 대시보드를 만드는 꼼꼼함은 AI가 훨씬 우수합니다.
비즈니스 맥락 정의: 숫자가 틀렸을 때 왜 틀렸는지(Why)를 조직의 사업 목표와 결합해 해석하는 능력, 즉 “CAC(고객 획득 비용)가 올랐는데, 이것이 브랜딩 투자 때문인가, 타깃 세그먼트의 이탈 때문인가?“를 종합적으로 판단하는 가설 설정 능력이 핵심이 됩니다.
2) 검색 의도(Search Intent) 너머의 ‘사용자 심리와 맥락’ 파악
- AI는 SEO 알고리즘의 최신 변경 사항이나 구조화 데이터(Schema Markup)를 완벽히 숙지할 수 있습니다.
- 하지만 검색창에 특정 키워드를 입력하는 사용자의 숨겨진 결핍, 즉 ‘검색 목적/의도 행동’의 미묘한 정서적 뉘앙스는 실제 타깃 고객과 소통하고 관찰하는 마케터의 직관에서 나옵니다.
3) LLM & GEO(Generative Engine Optimization) 감각 고도화
- 이제 마케팅의 전장은 전통적 검색 엔진을 넘어 퍼플렉시티, 챗GPT 등 생성형 AI의 추천 엔진(GEO)으로 확장되고 있습니다.
- AI가 데이터를 어떻게 읽고, 어떤 논리로 정보를 인용(Citation)하며 재구성하는지 ‘AI의 추론 메커니즘’을 역으로 이해하고 설계하는 기술적/구조적 감각을 반드시 탑재해야 합니다.
4) 질문(Prompting)과 검증(Auditing) 능력: 회의론적 검토 감각
논문 실험에서 인간이 AI의 올바른 답을 망치거나, 반대로 AI가 수정한 오답을 그대로 수용하는 사례가 관찰되었습니다.
마케터는 AI가 쏟아내는 수많은 페르소나와 카피, 데이터 분석 결과를 맹신하지 않고, 비즈니스 도메인 지식을 바탕으로 날카롭게 팩트체크하고 방향을 조율하는 ‘최종 의사결정권자’의 감각을 길러야 합니다.
AI 시대, 마케터의 생존 전략
AI가 주니어의 기술적 숙련도를 뛰어넘는 속도는 예상보다 훨씬 빠릅니다.
규칙을 따르고 숫자를 맞추는 일은 AI에게 맡기되, 문제를 정의하고, 사람의 마음을 움직이며, 불확실한 시장 상황에서 책임을 지고 결단을 내리는 감각—이것이 AI 시대에 대체 불가능한 마케터로 살아남는 유일한 열쇠입니다.